 Recruit Tech Blog


目次
はじめに
こんにちは!データ推進室の羽鳥、天野です。 普段はそれぞれ、LLMを使った推薦システムの開発と、データ組織のマネジメントに取り組んでいます。
2026年6月末から7月頭にかけて、米国サンフランシスコで開催された AI Engineer World’s Fair 2026 に、社内エンジニア3名で参加してきました。
昨年からLLMを前提とした開発の話題は増えましたが、業務のなかで「エージェントに何をどこまで任せるか」を設計するのは、まだ手探りの状態です。 本記事では、現地で聞いたセッションのなかから、開発フローとレビュー、エージェントの安全設計、レコメンドという3つの切り口でめぼしい内容を紹介します。
AI Engineer World’s Fair とは
AI Engineer World’s Fair は2024年から開催されているAIエンジニア向けのカンファレンスで、今年で3回目となります。 参加者は6,000名を超え、29トラックに300名のスピーカーが登壇しました。 規模感としては基調講演、ワークショップ、Expo の順に大きい構成でした。 発表者は各社の Senior や Staff エンジニアが中心で、入門的なガイダンスから内部実装に踏み込んだ話まで、粒度は幅広いものでした。 セッションの動画は 公式の YouTube チャンネル で順次公開されています。
開発フローとレビュー
このパートでは、エージェントを開発フローに組み込むうえでのループ設計と、コードレビューの位置づけを扱った3つのセッションを取り上げます。
Software Development Loops(HumanLayer 基調講演)
HumanLayer の Kyle Mistele 氏による基調講演です。 Peter Steinberger 氏の「プロンプトを書くのではなく、ループを設計せよ」という発言以降ループ開発が流行し、生成されるコードは多すぎるので読まなくてよい、という考え方まで出てきています。 これに対して Mistele 氏は、顧客や規制、SLA を抱えるチームでは誰も読まない4万行のプルリクエストは出せないとし、ループを使いつつコードは読み続けるべきだと主張しました。 コードを読まない開発がうまくいくかはまだはっきりせず、トークン予算が無制限でもない限り、悪いコードのツケはむしろ高くつくという見立てです。
その手段が、制御理論のサーモスタットに例えたループ設計です。 目指す状態(セットポイント)と現状の差をセンサーで測り、コントローラーが小さな変更を決め、エージェントがそれを適用します。 Kubernetes のオートスケーリングや IaC と同じく、小刻みに変えることでオーバーステアを避ける発想でした。 同じプロンプトでエージェントを回し続けるだけの「Ralph ループ」との違いは、この漸進性にあるといいます。
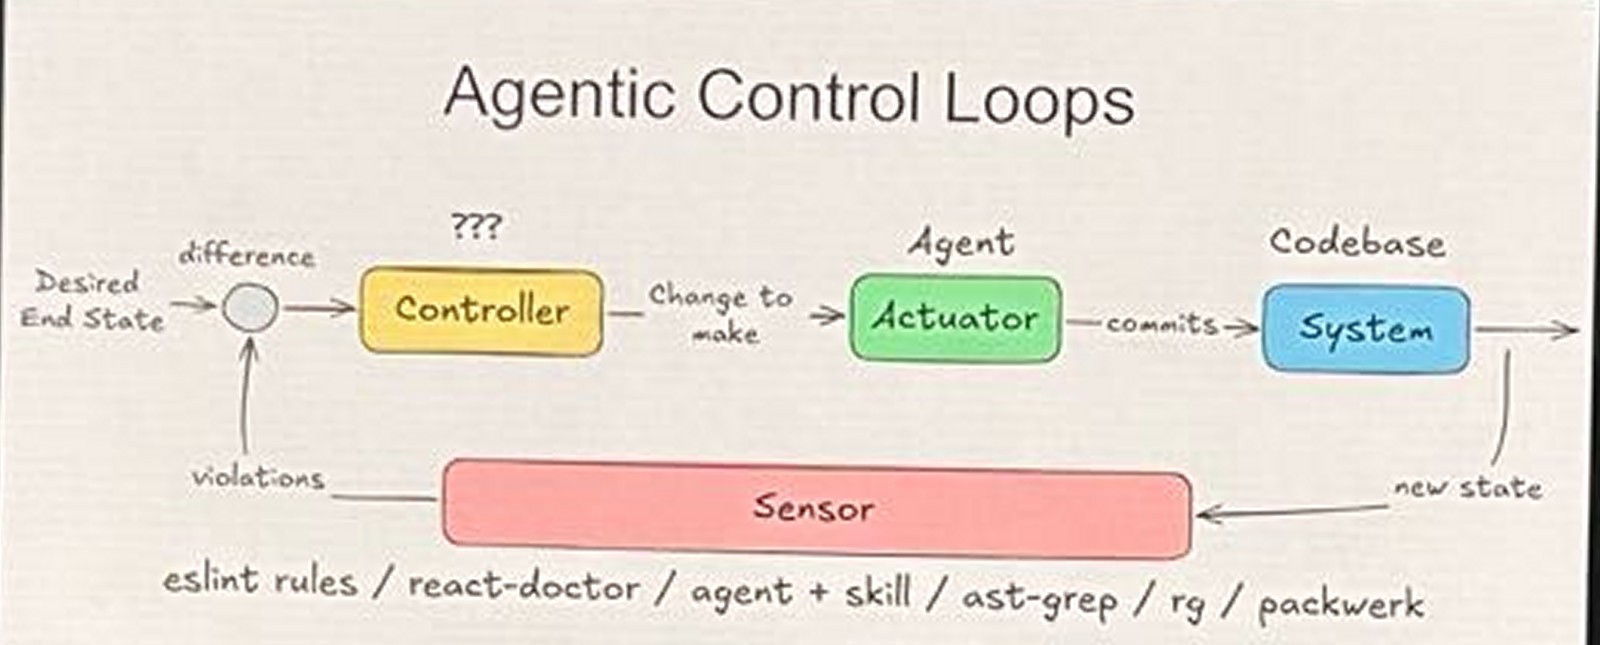
実例は、社内の RPC API を Effect(TypeScript のライブラリ)へ移行する取り組みです。
ast-grep で未移行の箇所を検出し、新しいプルリクエストで未移行の箇所が増えないようにチェックしたうえで、1件ずつエージェントに移行させます。
ループは GitHub Actions で毎日実行し、毎朝小さなプルリクエストが1件届くようにしています。
レビューで /iterate とコメントすると、コードの修正とあわせてフィードバックファイルも更新され、走らせたまま軌道修正できます。
印象的だったのは、ループごとに同時オープンなプルリクエストを1件までに絞るルールです。 前回分が未レビューならループは何もせずに終わるため、エージェントの速度ではなく、人間のレビュー能力に合わせて流量を制御できます。 ループに自信が持てたら、1回で複数件を別々のコンテキストで処理したり、ワークフローを並列に回したりして速度を上げればよい、という話でした。
Uber uReview:自動コードレビューの内製
Uber の Will Bond 氏と Ameya Ketkar 氏によるセッションです。 Uber は数千人規模で開発者を抱えており、プルリクエストの増加にともない、初回レビューまでの待ち時間が2024年の約3時間から、2026年には約9時間まで伸びていました。 Phabricator への対応、数百チームへの分散的なカスタマイズ、リスクに応じたレビューの出し分け、セキュリティ観点の一貫適用が必要だったことから、内製に踏み切ったそうです。
構成としては、複数のジェネレーターでコメントを生成し、後段で評価、分類、フィルタ、重複排除を行って、確度の高いコメントだけを返しています。 コメントへの反応の感情分類、指摘が実際に直されたかを示す addressed 率、エージェントの思考トレースを追って、品質とコストを改善していったといいます。 「モデルは自分が間違っていることを知らない」という表現が印象的で、そのためにチームがルールを書ける AI リンターや、ナレッジベースや過去のプルリクエストに接続したチーム独自のカスタムエージェントを用意しています。
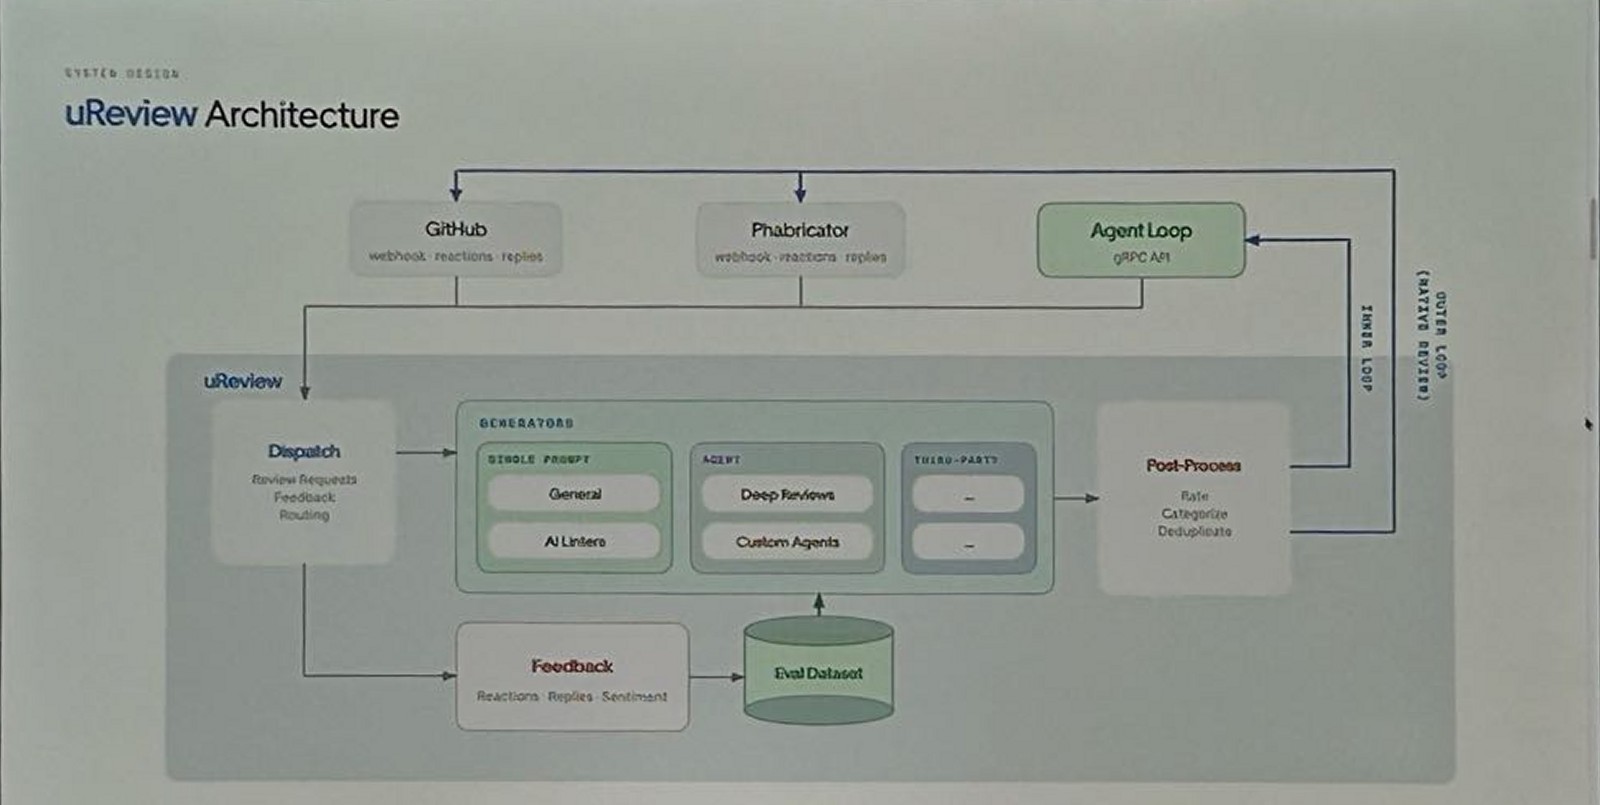
結果として、週に約25,000件のコメントが配信され、addressed 率は約67%、重大度が高い指摘に限れば約4分の3が直されています。 コストは60%削減、精度は約7%改善しました。 現時点では承認は人間が行っていますが、一部のコードが自動承認で入る段階も近いと見ているそうです。 それでも結論は「人間をレビューから排除するのではなく、アウターループを拡張する」というもので、人間はアーキテクチャやドメイン知識、プロダクトの観点に責務を移していく方向です。
HumanLayer: Why Software Factories Fail
HumanLayer からは、Dex Horthy 氏も基調講演に登壇しました。 Uber と同じレビューという主題を、真逆に近い立場から扱っています。 「Context Engineering」を提唱している人物で、主張は「ハーネス(エージェントを動かす土台)だけでは足りない」という一文に集約されます。
Dex 氏自身、自社で lights-out(人間が介入しない完全自動化)を試したものの、数か月で破綻したと語っていました。 モデルは人間の誘導なしにコードの品質を維持できない、というのが実感だといいます。 根本原因を Dex 氏は強化学習の報酬設計に置きました。 SWE-bench のようにテストが通ったかどうかだけで二値の報酬を与える学習環境では、設計の悪さや保守性の低下を罰する信号がありません。 保守性の劣化は月単位、年単位で顕在化する性質のもので、そもそも学習ループのなかに折り込むこと自体が難しいという指摘です。
対策としては、レビューに人間を戻し、上流の計画(プロダクトレビュー、アーキテクチャ、プログラム設計、vertical slices)に投資すべきだと主張していました。 「事前アライメントに30分かけることで、レビューに数時間かかるのを避けられる」「プルリクエストが多すぎるのではなく、悪いプルリクエストが多すぎるのだ」という表現が印象に残りました。
Uber と HumanLayer の対比
Uber と HumanLayer は、どちらも「エージェントが書く時代に、レビューのボトルネックをどう解くか」という同じ問いに向かっています。 一方で、両者の立場は温度差が大きいものでした。
Uber は実務のスケール側から入り、観測と個別チューニングを積み重ねて自動レビューの精度を上げ、自動承認に近づけていく方針です。 HumanLayer はモデル原理側から入り、報酬設計が解決するまで人間がコードを読むしかない、という慎重な立場でした。 Loops の講演が、コードを読み続ける前提でループを設計していたのも同じ考え方です。
両者に共通しているのは「人間の関与をより上のレイヤーに残す」という結論です。 Uber はこれをアウターループの拡張と呼び、HumanLayer は計画と設計への投資と呼びます。 呼び方は違いますが、レビューという行為を廃止するのではなく、エンジニアの役割の再設計とセットで考えるべきだ、という点で一致していました。
エージェントの安全と垂直統合
Hippocratic AI Polaris:診断しない領域に特化した患者向け音声AI
Hippocratic AI の Vivek Muppalla 氏によるセッションです。 同社は、患者向けの音声AIエージェントを提供している企業です。 音声AI「Polaris」は、退院後のフォロー、服薬確認、予約の管理といった非診断業務に特化しています。 累計で2億件を超える臨床インタラクションがあり、60以上の医療システムに導入されていて、重大な安全インシデントはゼロと報告されていました。
ライブデモでは、AIケアマネージャーが退院後の患者に電話し、薬剤名の聞き取り、バイタル値の復唱確認、服薬中止の指示が守られているかの確認を実演しました。 脚のだるさを訴える患者に胸の不快感や息切れを尋ね、「息切れ」の訴えが出た時点で人間の看護師へリアルタイムにエスカレーションする流れも見せていました。
技術面で目を引いたのは、音声認識から応答、音声合成、診療記録の作成まで、スタック全体を垂直統合で作り込んでいる点です。 賢いモデルは応答が遅く、速いモデルは安全な会話に足る精度がないため、両立させるには全体を自社で最適化するしかなかった、という説明でした。 音声認識では、Whisper large v3 を数百万件の臨床会話でファインチューニングしたうえで、患者の服薬情報などの文脈を与えて認識させ、医療用語の誤り率を既製のモデルより50%以上下げています。
Polaris の中核は、31のモデルを組み合わせた「コンステレーション」と呼ばれる構成です。 会話を主導するメインモデルに、過剰摂取、服薬中止、ラボ結果、エスカレーションなどを担う30を超える専門モデル(supervisor)と、ツール呼び出しや推論を検証する verifier を組み合わせています。 電話では0.5秒未満で応答する必要があるため、専門モデルはまず自分が口を挟む必要があるかを軽く判定し、不要ならすぐに処理を打ち切ります。 重い検証は、会話と並行して裏で非同期に実行します。
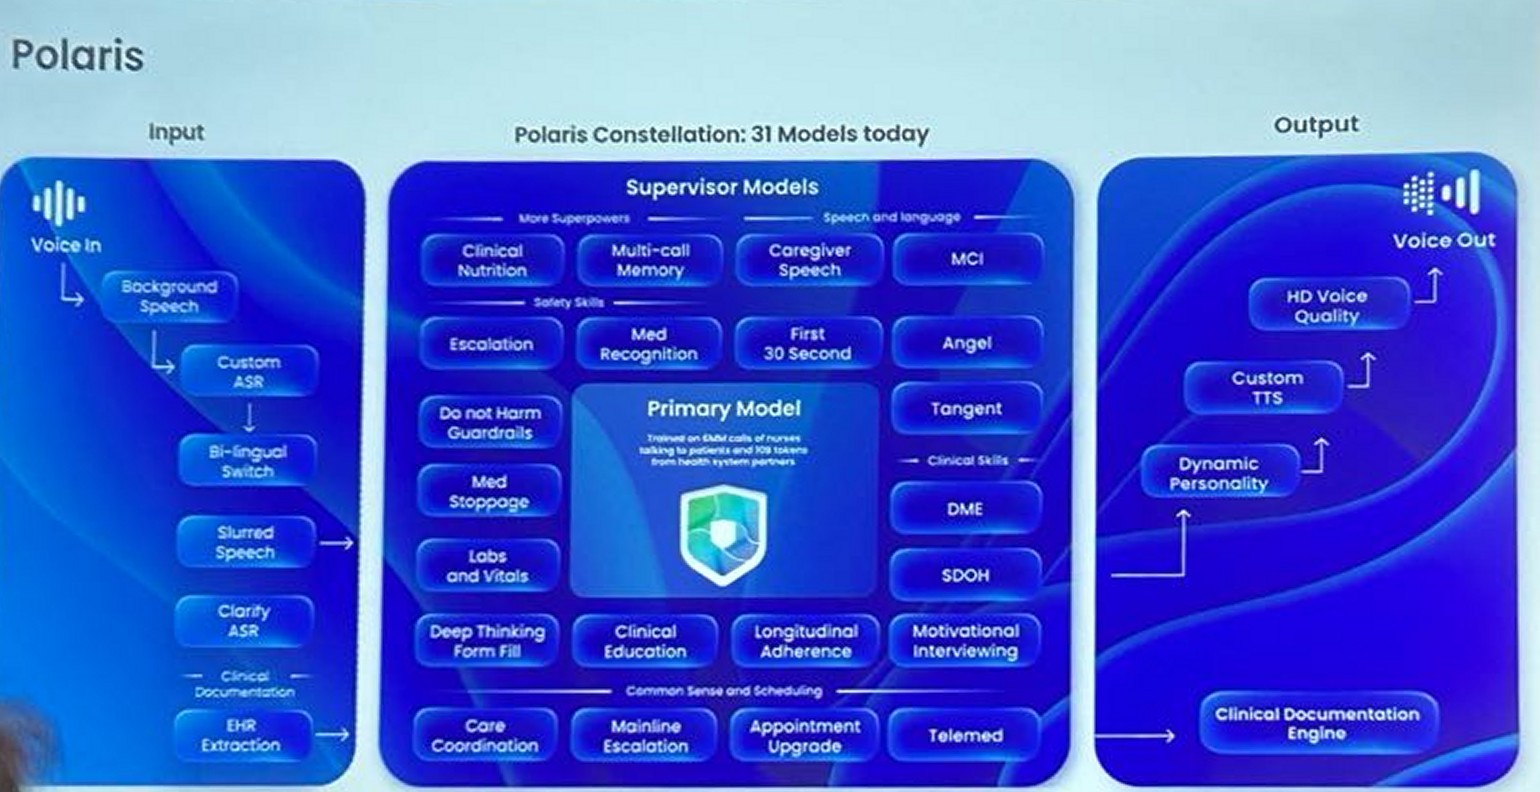
これによって、投薬エラー率は GPT-4o の10.9%から0.01%に、スケジューリングの幻覚は0.49%から0.13%に下がったといいます。
セッションで強調されていたのは「99%は十分ではない」という考え方です。 予約が1日1万件あれば、1%のミスでも毎日100人が誤った予約をすることになり、そのなかには受けられなかったがん検診も含まれます。 1%のエラーを99%の確度で1回観測するだけでも450件のテストが必要なため、7,750名を超える臨床テスターと合成データを組み合わせ、77.5万件超の通話で評価しています。 各通話は無害から死亡までの段階で採点され、5世代の改善を経て無害率は99.89%に達したそうです。
安全性はプロンプトではなく、多重監視のアーキテクチャと評価体制で作り込むもの、という結論でした。
LLM レコメンドと Semantic ID
このパートでは、LLM をレコメンドシステムの本体に据える動きのなかから、Semantic ID に焦点を当てて3社のセッションを取り上げます。 今回発表があった Meta、Spotify、DoorDash の3社が扱う対象領域は動画、音楽、EC と大きく異なりますが、発表内容は共通して「コンテンツを Semantic ID と呼ばれる離散トークン列に落としてモデルに学習させる」というものでした。 LLM ベースのレコメンドシステムは、ほぼ同じ形に収束しつつあるという印象を受けました。
Meta: Tokens In, Engagement Out
Meta の Devansh Tandon 氏(Principal Product Manager)によるセッションで、副題は「Training LLM-Recommenders」です。 主張は明快で、レコメンドも LLM と同じスケーリング則に乗り、単純で大きなモデルが複雑な工夫に勝つ、というものでした。 背景には、RecSys がそもそも LLM 以前から本番機械学習モデルとしては最大級の規模だったという事実があります。 ランキング、検索、埋め込みテーブルのいずれもスケール可能で、適切なアーキテクチャなら LLM のべき乗則がそのまま現れるという議論でした。
そのスケーリングを支えているのが、コンテンツを表す語彙としての Semantic ID です。 タイトルや説明、音声、映像フレームを埋め込みに落とし、RVQ で量子化した数個のトークンを、そのコンテンツの Semantic ID として使います。 説明で使われていた例が印象に残りました。
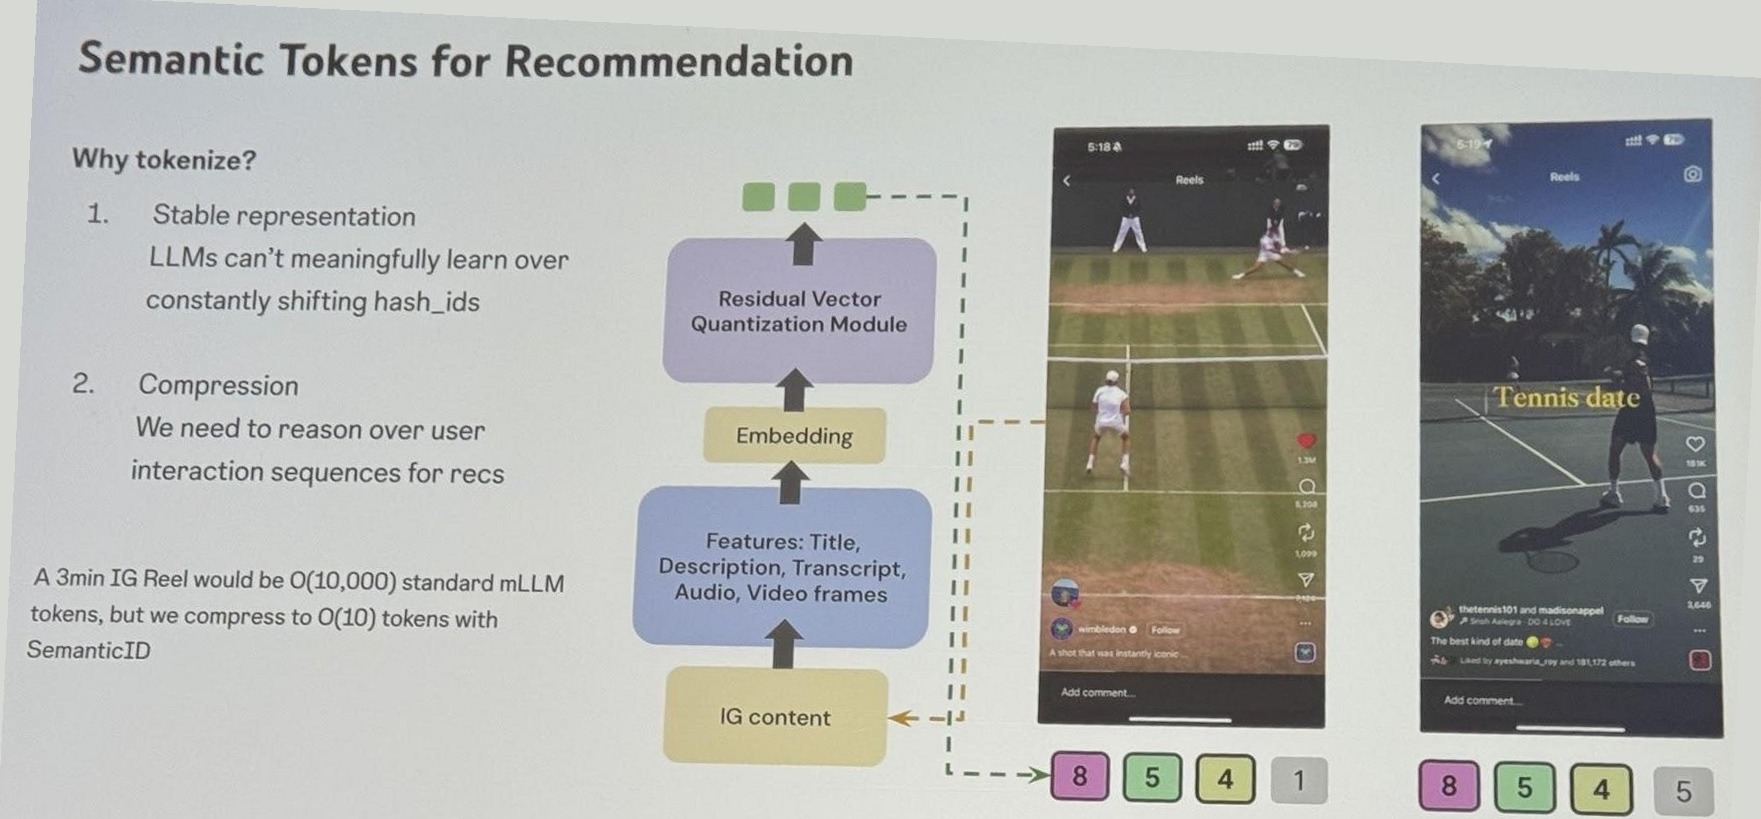
2本のテニス動画で上位3トークンが共通し、末尾だけが異なります。 共通部分が「テニス」という意味を、末尾が個別の動画を表す、階層的な構造です。 これによって、3分のリールが O(10,000) トークンから O(10) トークンに圧縮され、ランダムに振られたIDと違って、意味的にも安定した表現になります。 ドメイン専用の「新しい語彙」を作って、以降の pre/post-training や検索、生成の共通語彙として使う、というのが要点でした。
Spotify:NEO と Semantic ID
Spotify の Jacqueline Wood 氏(Staff ML Engineer)と Yves Raimond 氏(VP of Engineering)の共同セッションです。 MAU 7.61億のサービスが抱えるカタログを LLM が読める語彙に変換して、生成的で「操縦できる」パーソナライズへ移行する、という内容の発表でした。 研究段階の NEO だけでなく、Podcast Discovery で本番稼働している GLIDE や、Spotify DJ、Prompted Playlists、Taste Profile といった既存サービスまで LLM ベースのレコメンドシステムを地続きで扱っていた点が、印象に残りました。
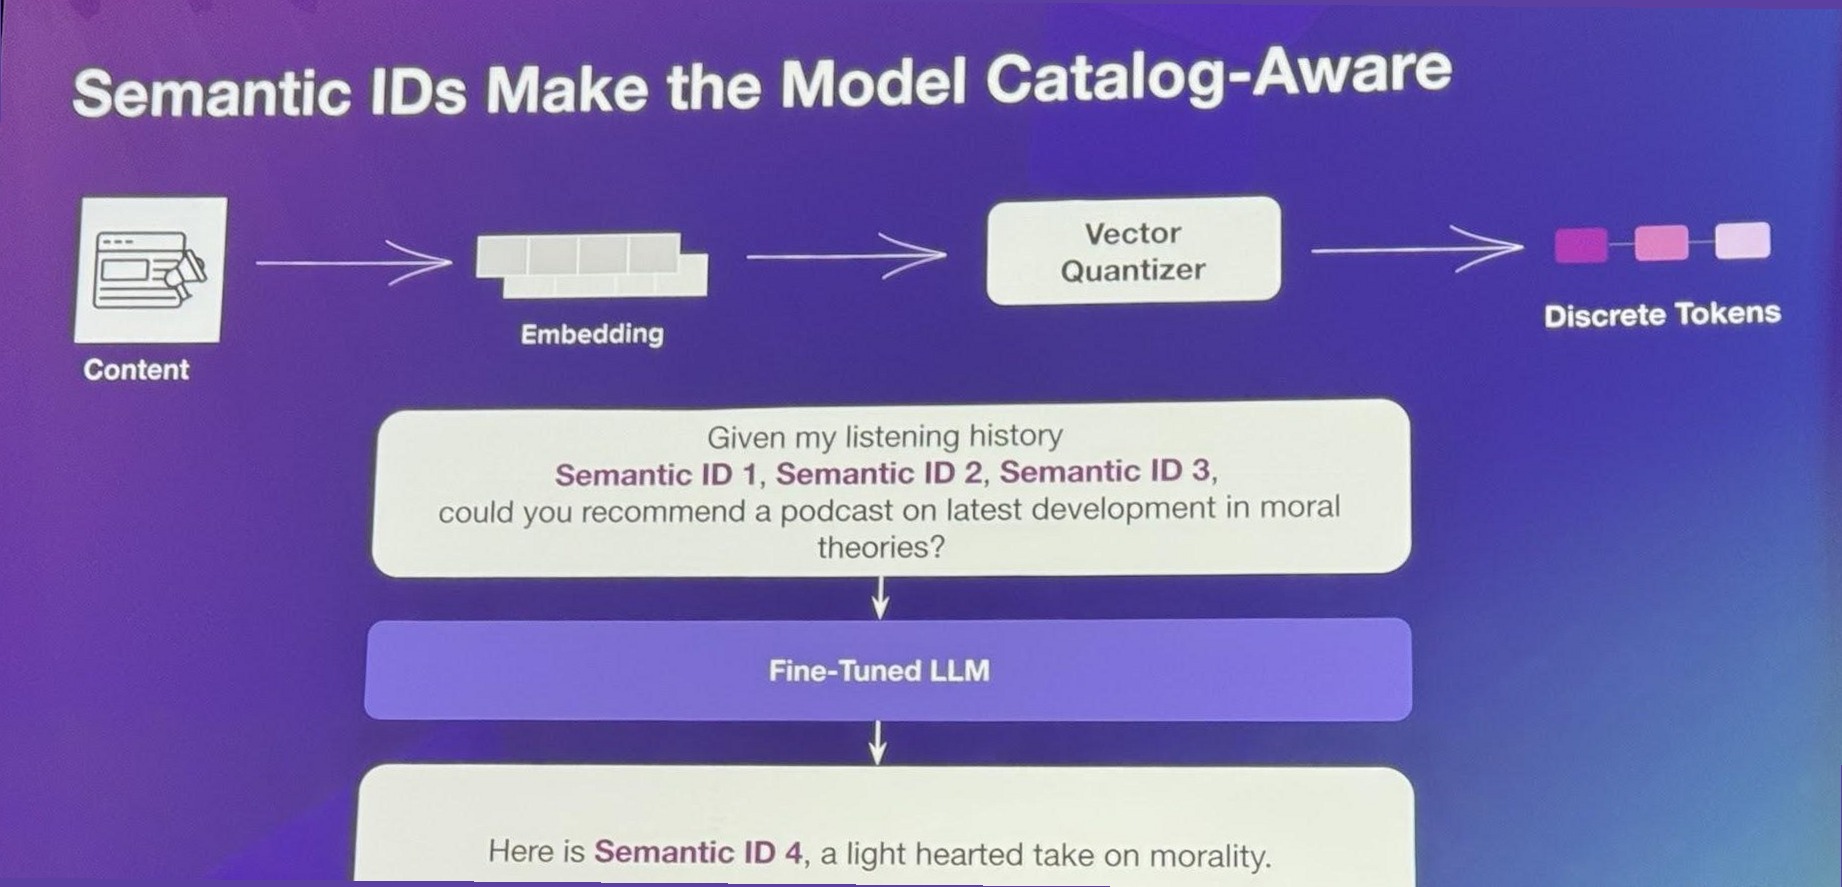
技術面の中核は Meta と同じく Semantic ID でした。 コンテンツを埋め込み、Vector Quantizer にかけて離散トークン列に落とします。 これを学習することによって、モデルが「カタログを知っている」状態になります。 対話としては「私の履歴 [SID1, SID2, SID3] を踏まえて道徳理論のポッドキャストを推薦して」に対して「SID4はどうでしょう、モラルを軽妙に扱う番組です」と返せる、というイメージでした。 NEO と GLIDE については、 Spotify Research のブログ記事 にまとまっています。
DoorDash:5,500万アイテムの Semantic ID
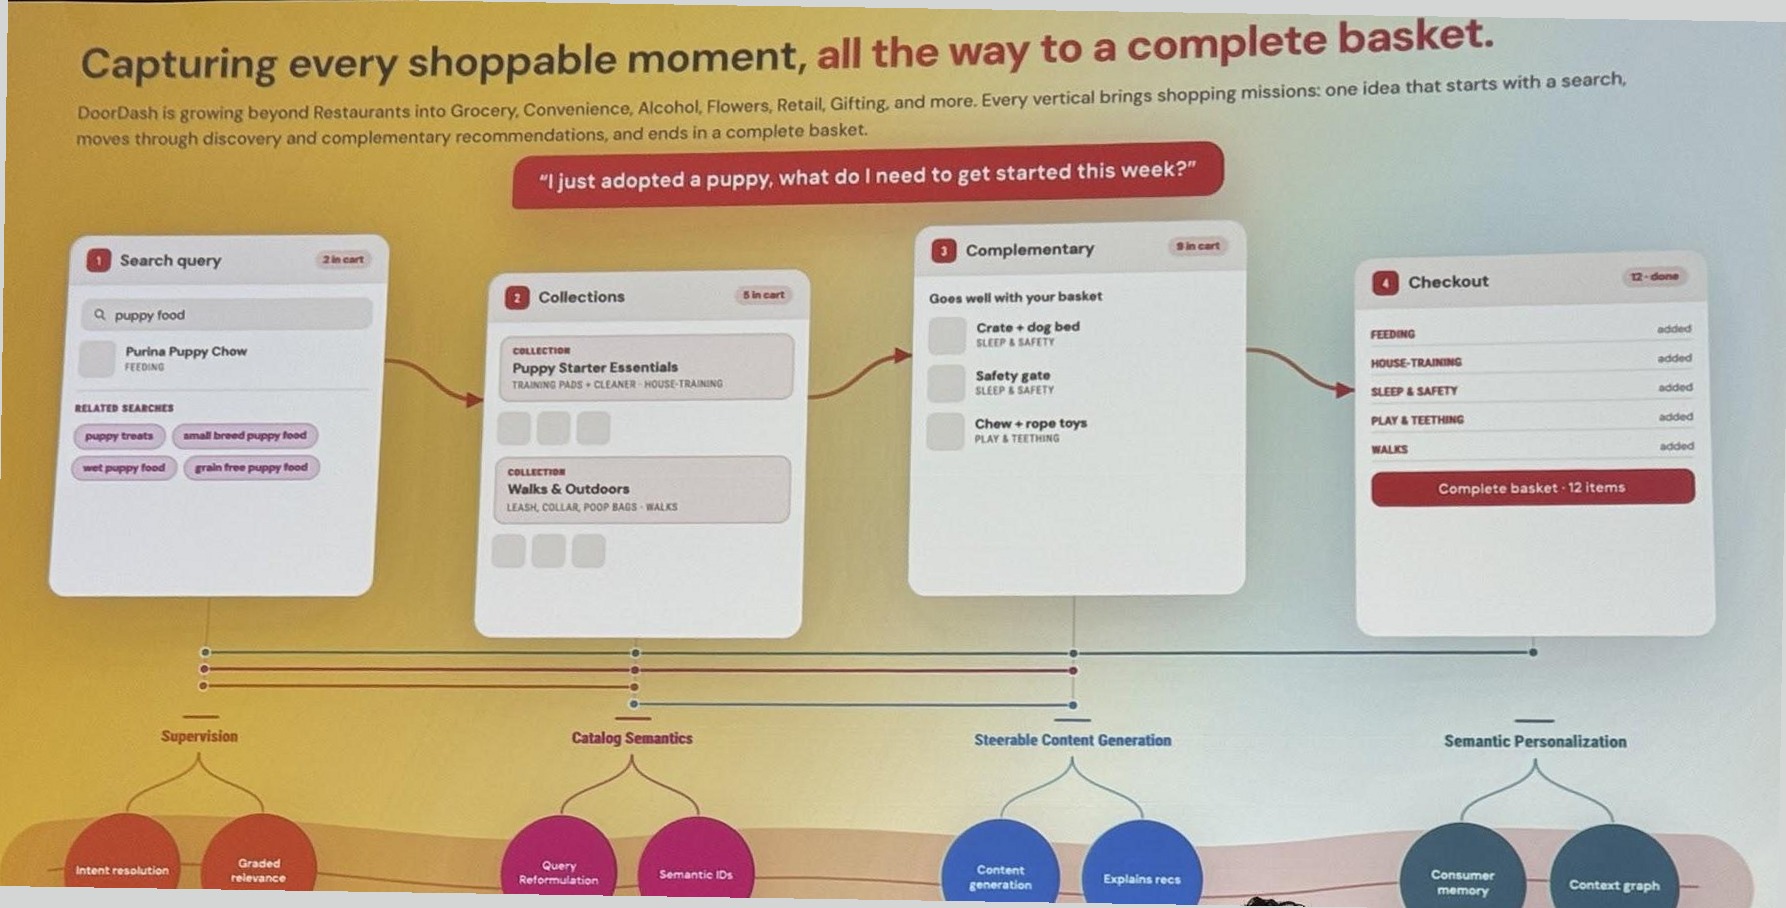
DoorDash の Raghav Saboo 氏(Staff ML Engineer, Tech Lead, New Verticals)によるセッションです。 もともとはレストランの料理配達(Uber Eats のような領域)から始まり、最近は食料品、コンビニ、酒など扱う対象が広がっているという背景がありました。 レストランの注文では「ピザを注文して終わり」ですが、一般小売の買い物では欲しいものが複数あるのが普通で、DoorDash のゴールは「欲しいものを全部カゴまで運ぶ」ことに移っています。 セッションで挙げられた典型的なミッションは「子犬を迎えた、今週何が必要?」で、検索からコレクション、補完推薦を経て、12点のアイテムがカートに入るまでを一気通貫で扱う、という話でした。
そのために用意されているのが、Supervision、Catalog Semantics、Semantic Personalization、Steerable Content Generation という4つのプリミティブです。 プリミティブとは、上位のものが組み合わせて使う最小の部品を指します。 セッションで示された図では、検索からコレクション、補完推薦、カートまでの各段階に対して、この4つが下から共通の層として敷かれていました。 どれもプロダクトの機能ではなく、retrieval / ranking / generation といった複数の下流モデルが再利用する共有表現を作る土台だ、というのが主張の軸でした。 ここでは、Meta や Spotify との共通点が最もはっきり出ていた Catalog Semantics に絞って紹介します。
Catalog Semantics は、5,500万アイテムに対する Semantic ID です。 Residual K-Means(最近傍セントロイド → 残差 → 残差)で階層的な Semantic ID を教師なしで学習し、例としては [237, 483, 46] のような列になります。 SKU ID は無情報、人手のタクソノミーは粗すぎる、その中間解、という位置づけでした。
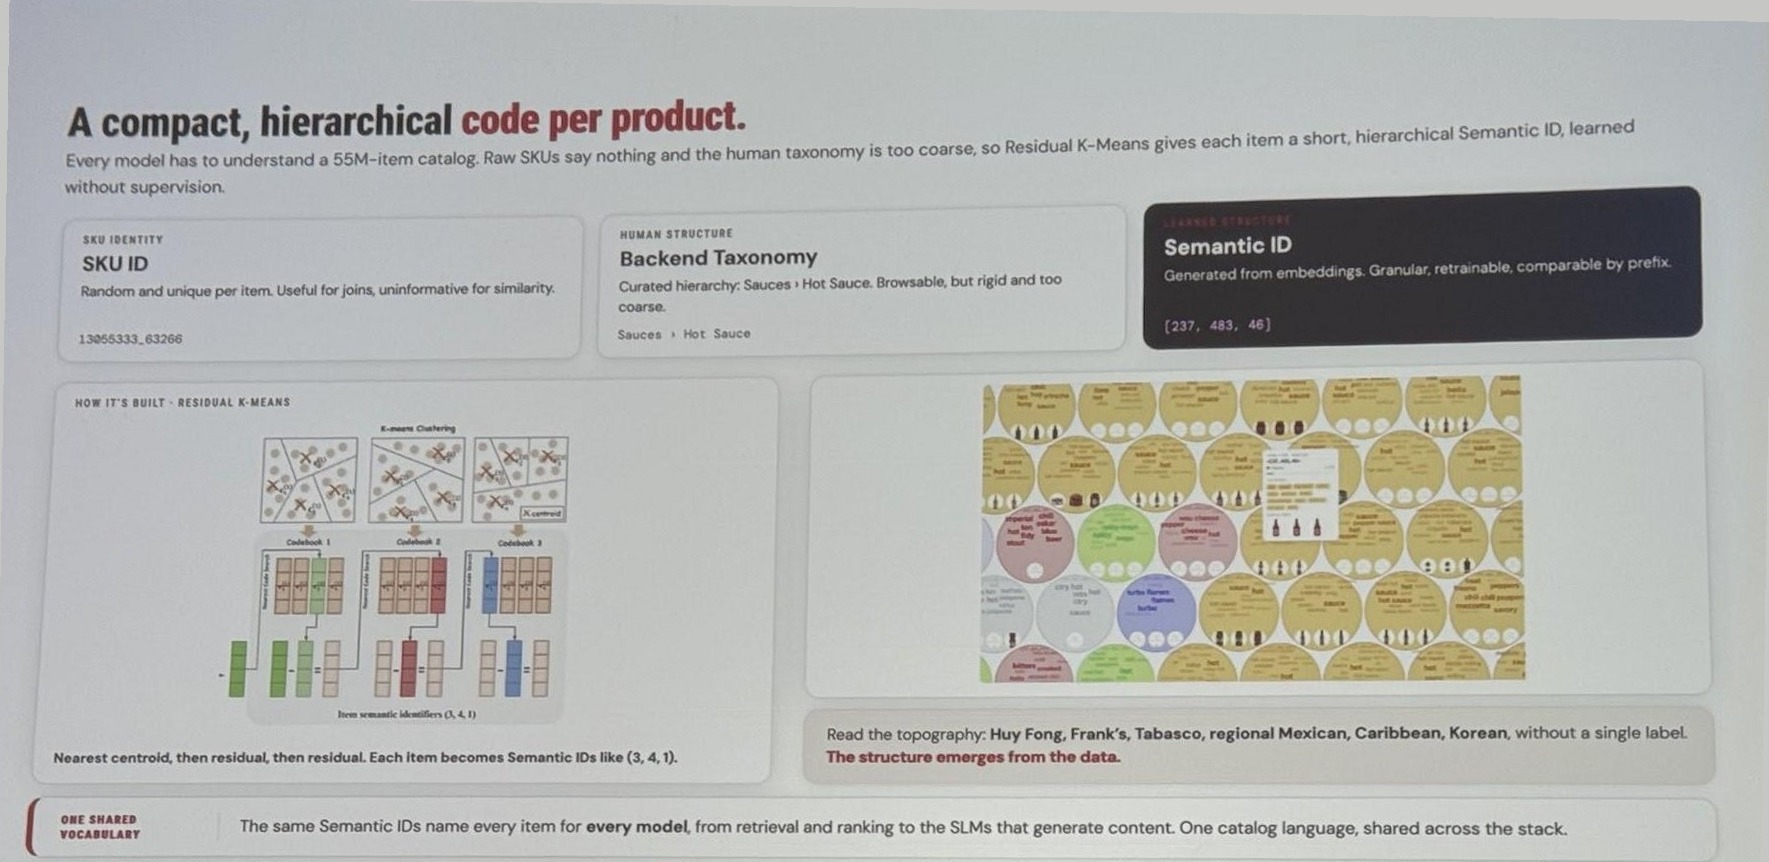
外部からラベルを与えていないのに、Huy Fong や Frank’s、Tabasco、地域別のメキシカン、カリビアン、韓国系といった区分が、それぞれのまとまりとして分かれていました。
カタログを Semantic ID という共通の語彙にするという点では、DoorDash も Meta や Spotify と同じ設計でした。
おわりに
開発フローの側では、エージェントが書く時代にレビューのボトルネックをどう解くかが共通の問いでした。 自動レビューを内製して精度を上げる立場と、上流の計画に投資する立場で温度差はありましたが、人間の関与をより上のレイヤーに残すという結論は一致していました。 安全性が問われる領域では、プロンプトではなくアーキテクチャと評価体制で品質を作り込む、という順序が徹底されていました。
レコメンドの側では、コンテンツを Semantic ID として離散化し、モデルとカタログの共通語彙にするアプローチが3社で共通していました。 対象領域が動画でも音楽でも EC でも同じ設計に辿り着いていたのが、今回一番の発見でした。
来年も現地に足を運んで、今年聞いた設計がどこまで進んだのかを確かめてきたいと思います。